Discussion: 新区开服
谷歌TPU首次对外销售有了确定答案:2026年10月22日,据汤姆硬件(Tom's Hardware)报道,Meta位于全球的数据中心已开始用谷歌TPU运行AI推理负载。PyTorch之父的团队成为该平台首批外部服务者,多数模型无需完成JAX移植即可运行。英伟达长期盘踞的AI芯片高地,第一次出现实质松动。
明星女友谷歌TPU首次对外销售:从内部算力到底盘开放
过去十年,谷歌TPU(张量处理单元)一直是这家搜索巨头最隐秘的算力资产。从2015年第一代TPU专攻推理加速,到2025年发布的第七代Ironwood,谷歌TPU几乎只服务自有业务:搜索排序、广告推荐、翻译系统以及Gemini大模型的训练与部署。谷歌对外姿态始终是"卖云算力",而非"卖芯片"。
明星未婚但10月22日汤姆硬件披露的交易打破了惯例。谷歌首次以硬件形式向外部客户供应TPU,Meta成为首批最大客户之一。芯片集成商RadixArk与推理基础设施公司Inferact深度参与:前者负责TPU服务器整机方案,后者提供面向PyTorch的推理服务层。Meta在自有数据中心内运行谷歌TPU,意味着这条供应链绕过了云租赁模式,直接嵌入竞争对手的核心基础设施。
明星结婚这并非小规模试点。消息人士确认,Meta已将谷歌TPU集群投入生产环境,与英伟达GPU混合调度,承载包括推荐系统和生成式AI在内的混合负载。
明星怀孕Ironwood的算力账:七代演进交出什么答卷
谷歌TPU能进入Meta数据中心的底气,来自第七代Ironwood芯片。2025年4月发布时,谷歌给出的参数相当激进:BF16精度下单芯片算力达到4614 TFLOPs,峰值集群性能突破exaflops级,单芯片峰值功耗控制在1217瓦。与上一代Trillium相比,Ironwood在相同功耗下把每瓦算力提升了接近5倍。
明星产子
这一数据直接对标英伟达当打旗舰GB200。在实际推理场景中,TPU矩阵运算单元针对Transformer结构做了深度优化,线性层与注意力机制的执行效率高于通用GPU。市场分析机构曾测算,在同等规模的LLM推理部署中,谷歌TPU的单位token成本可压低至GPU方案的六到七成。
Meta、RadixArk、Inferact三方名单首次公开,也让外界看清TPU外售的真实形态:芯片、整机与推理软件栈打包交付。这不是谷歌云的延伸服务,而是一套完整硬件供应链。
PyTorch之父站台:杀手锏是"不用换生态"
如果说Ironwood的算力是敲门砖,那么软件生态打通才是让大客户真正放心下单的理由。PyTorch创始人Soumith Chintala接受汤姆硬件采访时透露:"我们团队的模型已经在谷歌TPU上稳定跑了几周,绝大多数代码不用动,根本不涉及JAX移植。"
这句话的分量在于:TPU的编程模型长期绑定JAX和TensorFlow,而全球AI研究者九成以上使用PyTorch。Soumith的团队通过Inferact提供的中介层,用SGLang和vLLM两个开源推理框架直接调度TPU,屏蔽了底层指令差异。
他补充道:"AI产业不需要再复制一套生态。谁能兼容PyTorch,谁就能拿到下一轮大规模部署的门票。"
AI推理市场变局:英伟达护城河出现裂缝
彭博社援引行业数据指出,英伟达目前仍占据AI加速器市场约80%的份额,其中训练侧优势更明显。但推理侧正在成为增速最快的细分市场——2026年全球推理算力支出增速数倍于训练侧。
推理负载特性与训练截然不同:对绝对峰值算力要求有限,对延迟、吞吐和能效敏感。谷歌TPU架构恰好契合这一需求。Al Jazeera的科技评论也确认,Meta作为全球最大AI推理消耗方之一,选择谷歌TPU被业内视为对"GPU单极格局"的一次投票。
对英伟达而言,更棘手的变量是云厂商自研芯片竞赛:谷歌TPU外售、亚马逊Trainium商用、微软Maia项目推进。三年前还焊死的护城河,如今布满凿痕。
TPU演进时间线:从搜索加速器到对外商品
| 代次 | 发布年份 | 关键变化 | 适用场景 |
|---|
| --- | --- | --- | --- |
|---|
| TPU v1 | 2015年 | 专用推理加速,用于搜索/广告 | 推理 |
|---|
| TPU v2 | 2017年 | 支持训练,开放Cloud TPU租赁 | 训练+推理 |
|---|
| TPU v3 | 2018年 | 液冷架构,算力翻倍 | 大规模训练 |
|---|
| TPU v4 | 2021年 | 4096芯片互联,光交换网络 | 超大规模训练 |
|---|
| TPU v5e/v5p | 2023年 | 兼顾成本与吞吐的均衡设计 | 混合负载 |
|---|
| TPU v6(Trillium) | 2024年 | 单芯片性能提升约4.7倍 | 推理/训练 |
|---|
| TPU v7(Ironwood) | 2025年 | 首次向外部客户销售 | 推理优先 |
|---|
从表格不难看出,谷歌用十年完成了从"自用加速器"到"通用AI芯片"的转身。Ironwood外售并非孤立事件,而是这条曲线的必然延伸。
生态胜负手:SGLang与vLLM的推力
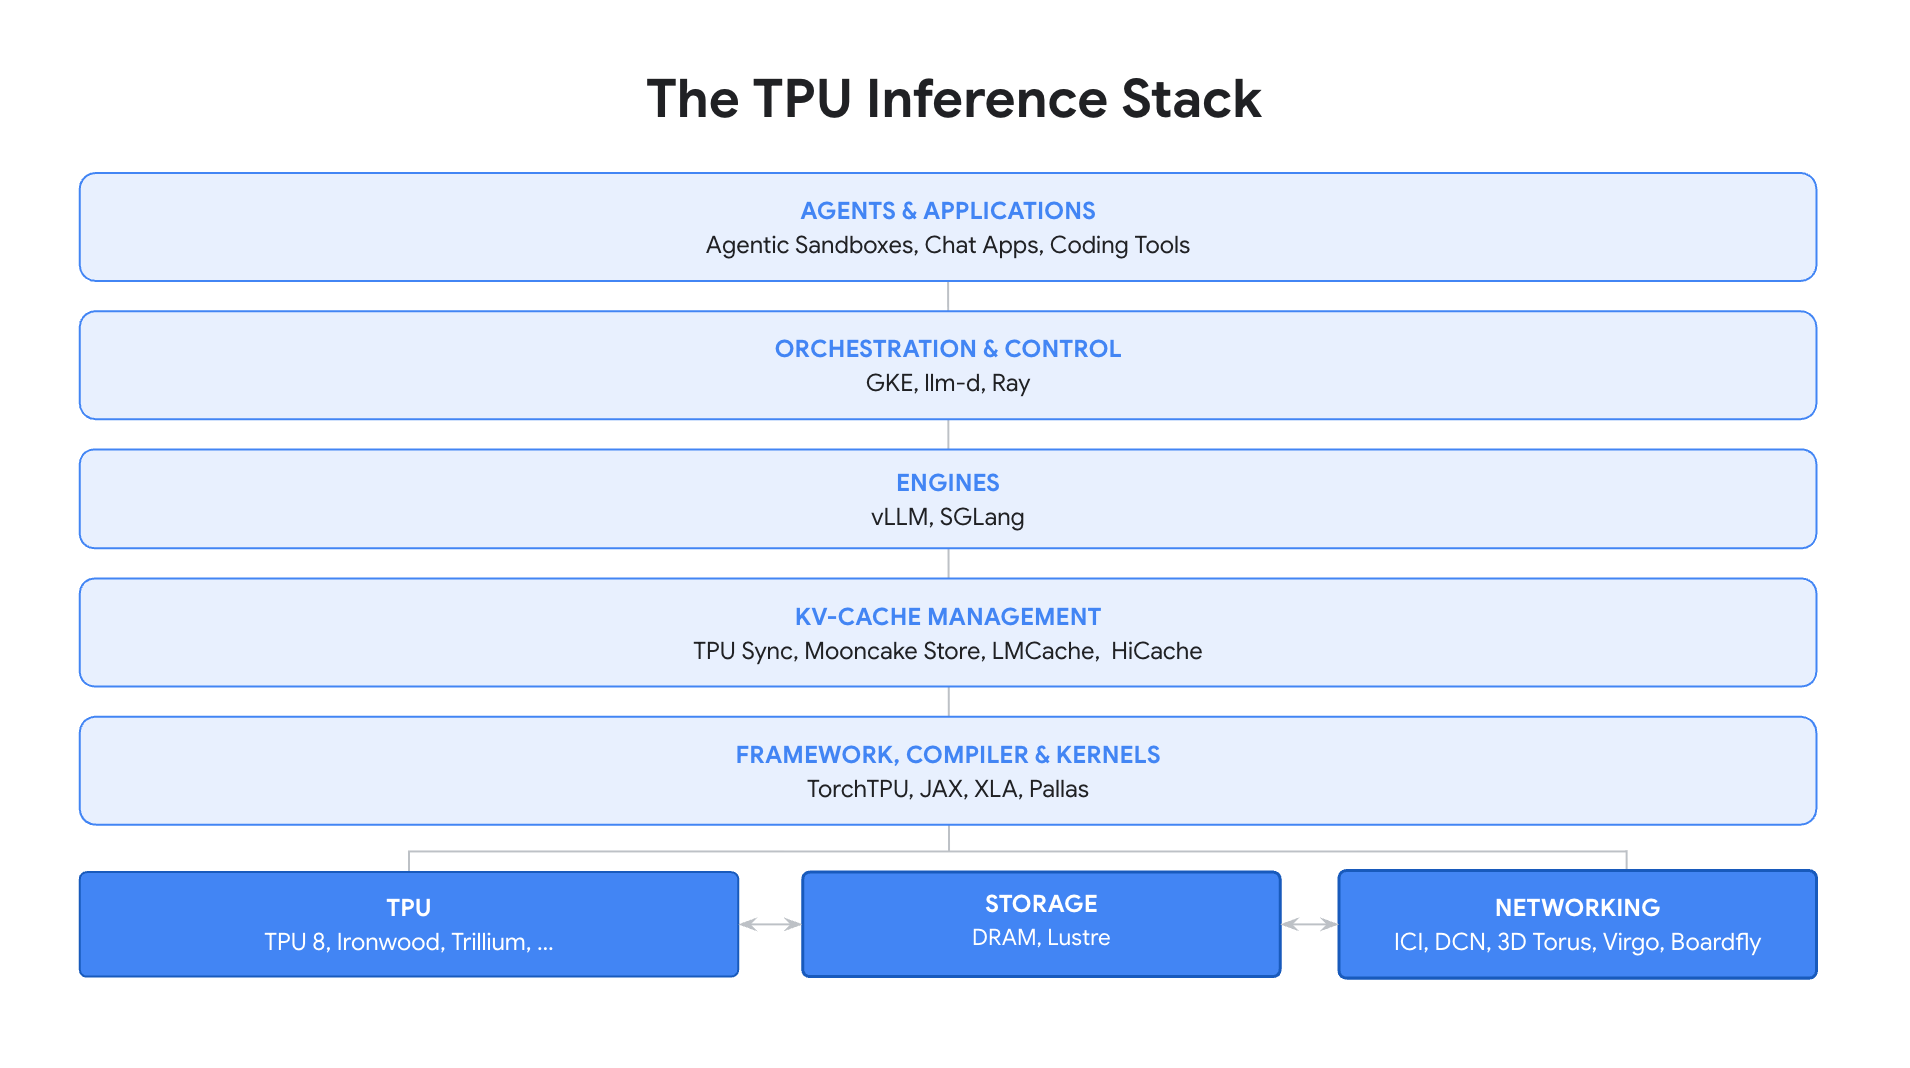
Inferact这一名字首次大规模出现在公众视野,其价值在于把复杂的TPU适配工作封装成开发者熟悉的一行命令。SGLang和vLLM已能通过插件式后端调用TPU资源,吞吐量在部分Llama模型基准上达到与H100持平的水平。
RadixArk则负责硬件调优,将Ironwood与高带宽显存、定制散热系统整合成标准化机架。两家公司均拒绝透露交易金额,但消息人士称,Meta订单规模达到数千个TPU加速卡量级,对应金额可能达数亿美元。
对普通AI开发者而言,这一变化的直接后果是:云服务商GPU价格可能被迫下调,推理成本随竞争加剧而下降。多架构算力时代,正在从口号变成现实。
常见问题
Q1:谷歌TPU对外销售,对英伟达的冲击到底有多大?
A1:短期实际冲击有限——英伟达在训练市场的主导地位依然稳固,谷歌TPU外售产能受制于自身供应链。但信号意义重大:全球最大推理需求方Meta首次接纳非英伟达大规模部署,验证了TPU在推理场景的性价比优势。若Meta实践数据被证明可靠,更多云厂商和大型企业可能跟进,英伟达在推理市场的份额将被逐年侵蚀。
Q2:为什么PyTorch兼容性对TPU如此关键?
A2:PyTorch是全球AI研究的默认框架,掌握PyTorch生态等同掌握开发者心智。谷歌TPU过去依赖JAX/TensorFlow生态,外部团队迁移成本高。PyTorch创始人亲自验证"无需移植即可运行",消除大客户最后一道顾虑,也为SGLang、vLLM等开源工具链全面支持TPU铺平了道路。
未来12个月,英伟达Blackwell定价与谷歌TPU产能爬坡,将共同决定AI算力市场走向。谷歌十年的技术积攒已然亮相,英伟达则需证明护城河不止先发优势。谷歌TPU首次对外销售,让算力之争进入下半场。
Related Threads - 剧集评分
谷歌TPU首次对外销售落地Meta数据中心,AI推理芯片市场格局剧变。据汤姆硬件2026年10月22日报道,PyTorch之父团队已用谷歌TPU运行模型且无需JAX移植,英伟达80%的AI加速器市占率正遭遇最强挑战。一文读懂算力新战局。