Discussion: 收视数据
据存储评论网(StorageReview)于2026年10月8日报道,企业存储软件公司Scality(斯卡利蒂)正式发布“Scality AI推理工厂”——一套运行自有基础设施上的开源权重模型推理栈。该方案将KV缓存卸载至对象存储层,通过RDMA高速网络直连GPU,在14K token上下文中实现166毫秒的热启动首令牌延迟,比重计算快14倍。工厂旨在为企业、政府及云服务商提供可控、低成本的私有化AI推理替代方案。
明星夫妻分离式架构:推理流水线的硬件级重构
Scality AI推理工厂采用“预填充-解码分离”的GPU池架构。传统推理服务中,单个GPU既要计算KV缓存又要执行解码,而工厂将两者物理分离:预填充池计算新提示的KV缓存并写入对象存储,解码池直接从存储读取缓存继续生成。这种设计使每个GPU池可以独立扩展,资源利用率大幅提升。根据Scality官方介绍,底层存储层是Scality ADI(AI数据基础设施),它通过Scality AI连接器与GPU集群相连。连接器替换了标准S3协议的控制平面,采用单次认证并移除XML与多部件封装的冗余开销,实现了更高效率。
明星情侣RDMA数据路径:绕过CPU实现线速访问
缓存读取路径中,GPU首先预留内存并告知ADI需要哪个对象。存储服务器将对象从TLC NVMe闪存加载到自身RAM,然后网卡通过RDMA直接将数据写入GPU内存,完全绕过CPU及操作系统协议栈。Scality CTO乔治·雷格尼(Giorgio Regni)表示:“ADI上的KV缓存速度快到可以放在推理路径中。从ADI恢复上下文的耗时与GPU内存相当,比重计算快14倍,且GPU在整个过程中保持忙碌。存储不再是保留KV缓存在GPU服务器内部的理由。”该数据路径在测试中达到网络线速的97%。
明星家庭基准测试:延迟、容量与加载速度的关键数据
Scality在小型实验室中进行性能验证:一台8GPU服务器、5台数代前的存储服务器、4条100Gb/s RDMA链路(网络成为瓶颈)。正式产品运行在400Gb/s网络上。以下是主要测试结果:
豪门八卦| 指标 | 场景 | 数值 | 对比/说明 |
|---|
| ------ | ------ | ------ | ----------- |
|---|
| 热启动首令牌延迟 | 14K token上下文 | 166 ms | 自ADI恢复缓存;相同上下文从GPU HBM读取为83 ms;纯重新计算需2.3秒,加速14倍 |
|---|
| 大上下文延迟 | 438,764 token上下文(GLM-5.2) | 7.3秒 | 重新计算需529秒,加速72倍;单会话产生189GB KV缓存(约430KB/token) |
|---|
| 多会话缓存容量 | 1个vLLM实例/GPU | 8TB | 相当于单GPU内存80倍,整台服务器10倍;支持约1000个并发会话无需重新计算 |
|---|
| 模型权重加载 | Gemma-3 27B(54.86GB) | 1.9秒 | 约28.9GB/s,是本地GPU服务器磁盘的10倍,因读取分散在存储层多块NVMe |
|---|
| 最大理论缓存大小 | 任意规模 | 1000次/日 | GPU可根据负载每天更换模型高达千次 |
|---|
值得注意的是,当缓存容量从69GB增加到8TB时,首令牌延迟稳定在355-373毫秒之间,说明ADI存储缓存不存在规模瓶颈。
豪门恩怨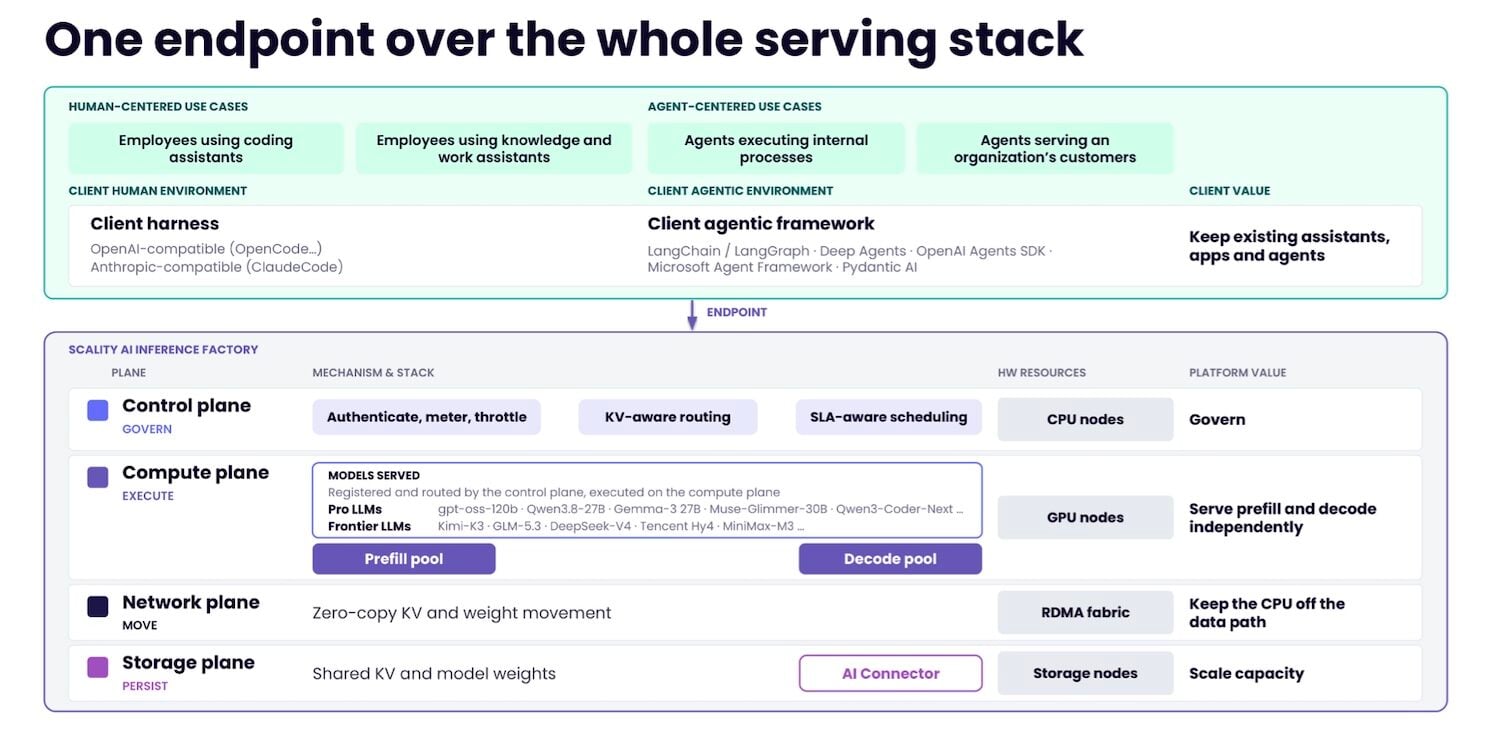
缓存卸载的数学优势:为何比重计算便宜
对于长上下文推理,KV缓存的大小远超GPU显存。例如438K token的会话产生189GB缓存,而即使8卡H100总HBM也仅约1.6TB,扣除模型权重后可用空间更少。传统做法必须重新计算上下文,耗时数分钟。Scality通过以对象形式将缓存持久化到ADI,使任何解码GPU均可启动现有会话。乔治·雷格尼指出:“仓储不再是限制。你用对象存储获取了几乎无限的缓存容量,而成本仅为GPU内存的零头。”测试中,存储层在4条100Gb/s链路上达到28.9GB/s吞吐,接近58%的理论极限,并通过稀疏读取模式实现毫秒级延迟。
开源生态与硬件兼容性
Scality AI推理工厂将开源组件(vLLM、Dynamo、ModelExpress)与自研连接器整合,并已向上游提交修复——例如修正了vLLM的KV卸载连接器,使其不再每个恢复请求抓取约5倍的冗余缓存块。所有软件组件均以开源代码交付,客户可审计推理状态流动路径。兼容的模型家族包括Mistral、Gemma、Qwen、DeepSeek、GLM、gpt-oss等;框架支持OpenCode、LangGraph、Pydantic AI等。硬件层面,ADI运行在标准Dell、HPE、Lenovo、Supermicro服务器上,支持多PB级NVMe + HDD + 可选磁带的分层命名空间,自动将冷层数据转移至成本更低的介质。
定价与可用性
Scality AI推理工厂现已上市,提供软件许可和全托管服务两种模式。Scality表示,每token定价随着工作流增长会不断膨胀,而私有部署允许用户自行控制模型版本、量化方式及数据安全。工厂在2026年10月8日于巴黎举行的Scality Day上进行现场演示。
Q1: Scality AI推理工厂主要解决什么问题?
A1: 它解决了云端推理成本不可控、数据主权受限以及长上下文推理中KV缓存无法高效保存的问题。通过将KV缓存卸载至对象存储并通过RDMA直连GPU,实现了14倍以上的推理加速,同时支持数百个并发会话无需重计算,并允许企业在自有数据中心运行开源权重模型。
Q2: 该方案是否依赖特定GPU品牌?
A2: 不依赖。工厂通过RDMA与标准PCIe网卡交互,GPU只需支持RDMA即可(如NVIDIA、AMD等)。Scality已在多款GPU上进行验证,并强调连接器不修改vLLM核心,因此兼容主流加速卡。
Scality AI推理工厂展示了对象存储在AI推理领域的新角色:不仅存放数据,更成为推理流水线中的主动参与者。通过RDMA直连与KV缓存卸载,它打破了GPU内存壁,为长上下文、高并发的私有化AI部署提供了性价比显著更高的选择。
Related Threads - 英雄攻略
Scality推出AI推理工厂,通过RDMA直连对象存储提供KV缓存,在14K token上下文中实现166ms热启动首令牌,比重计算快14倍,支持8TB缓存容量与千级并发。



