Discussion: 仙侠手游
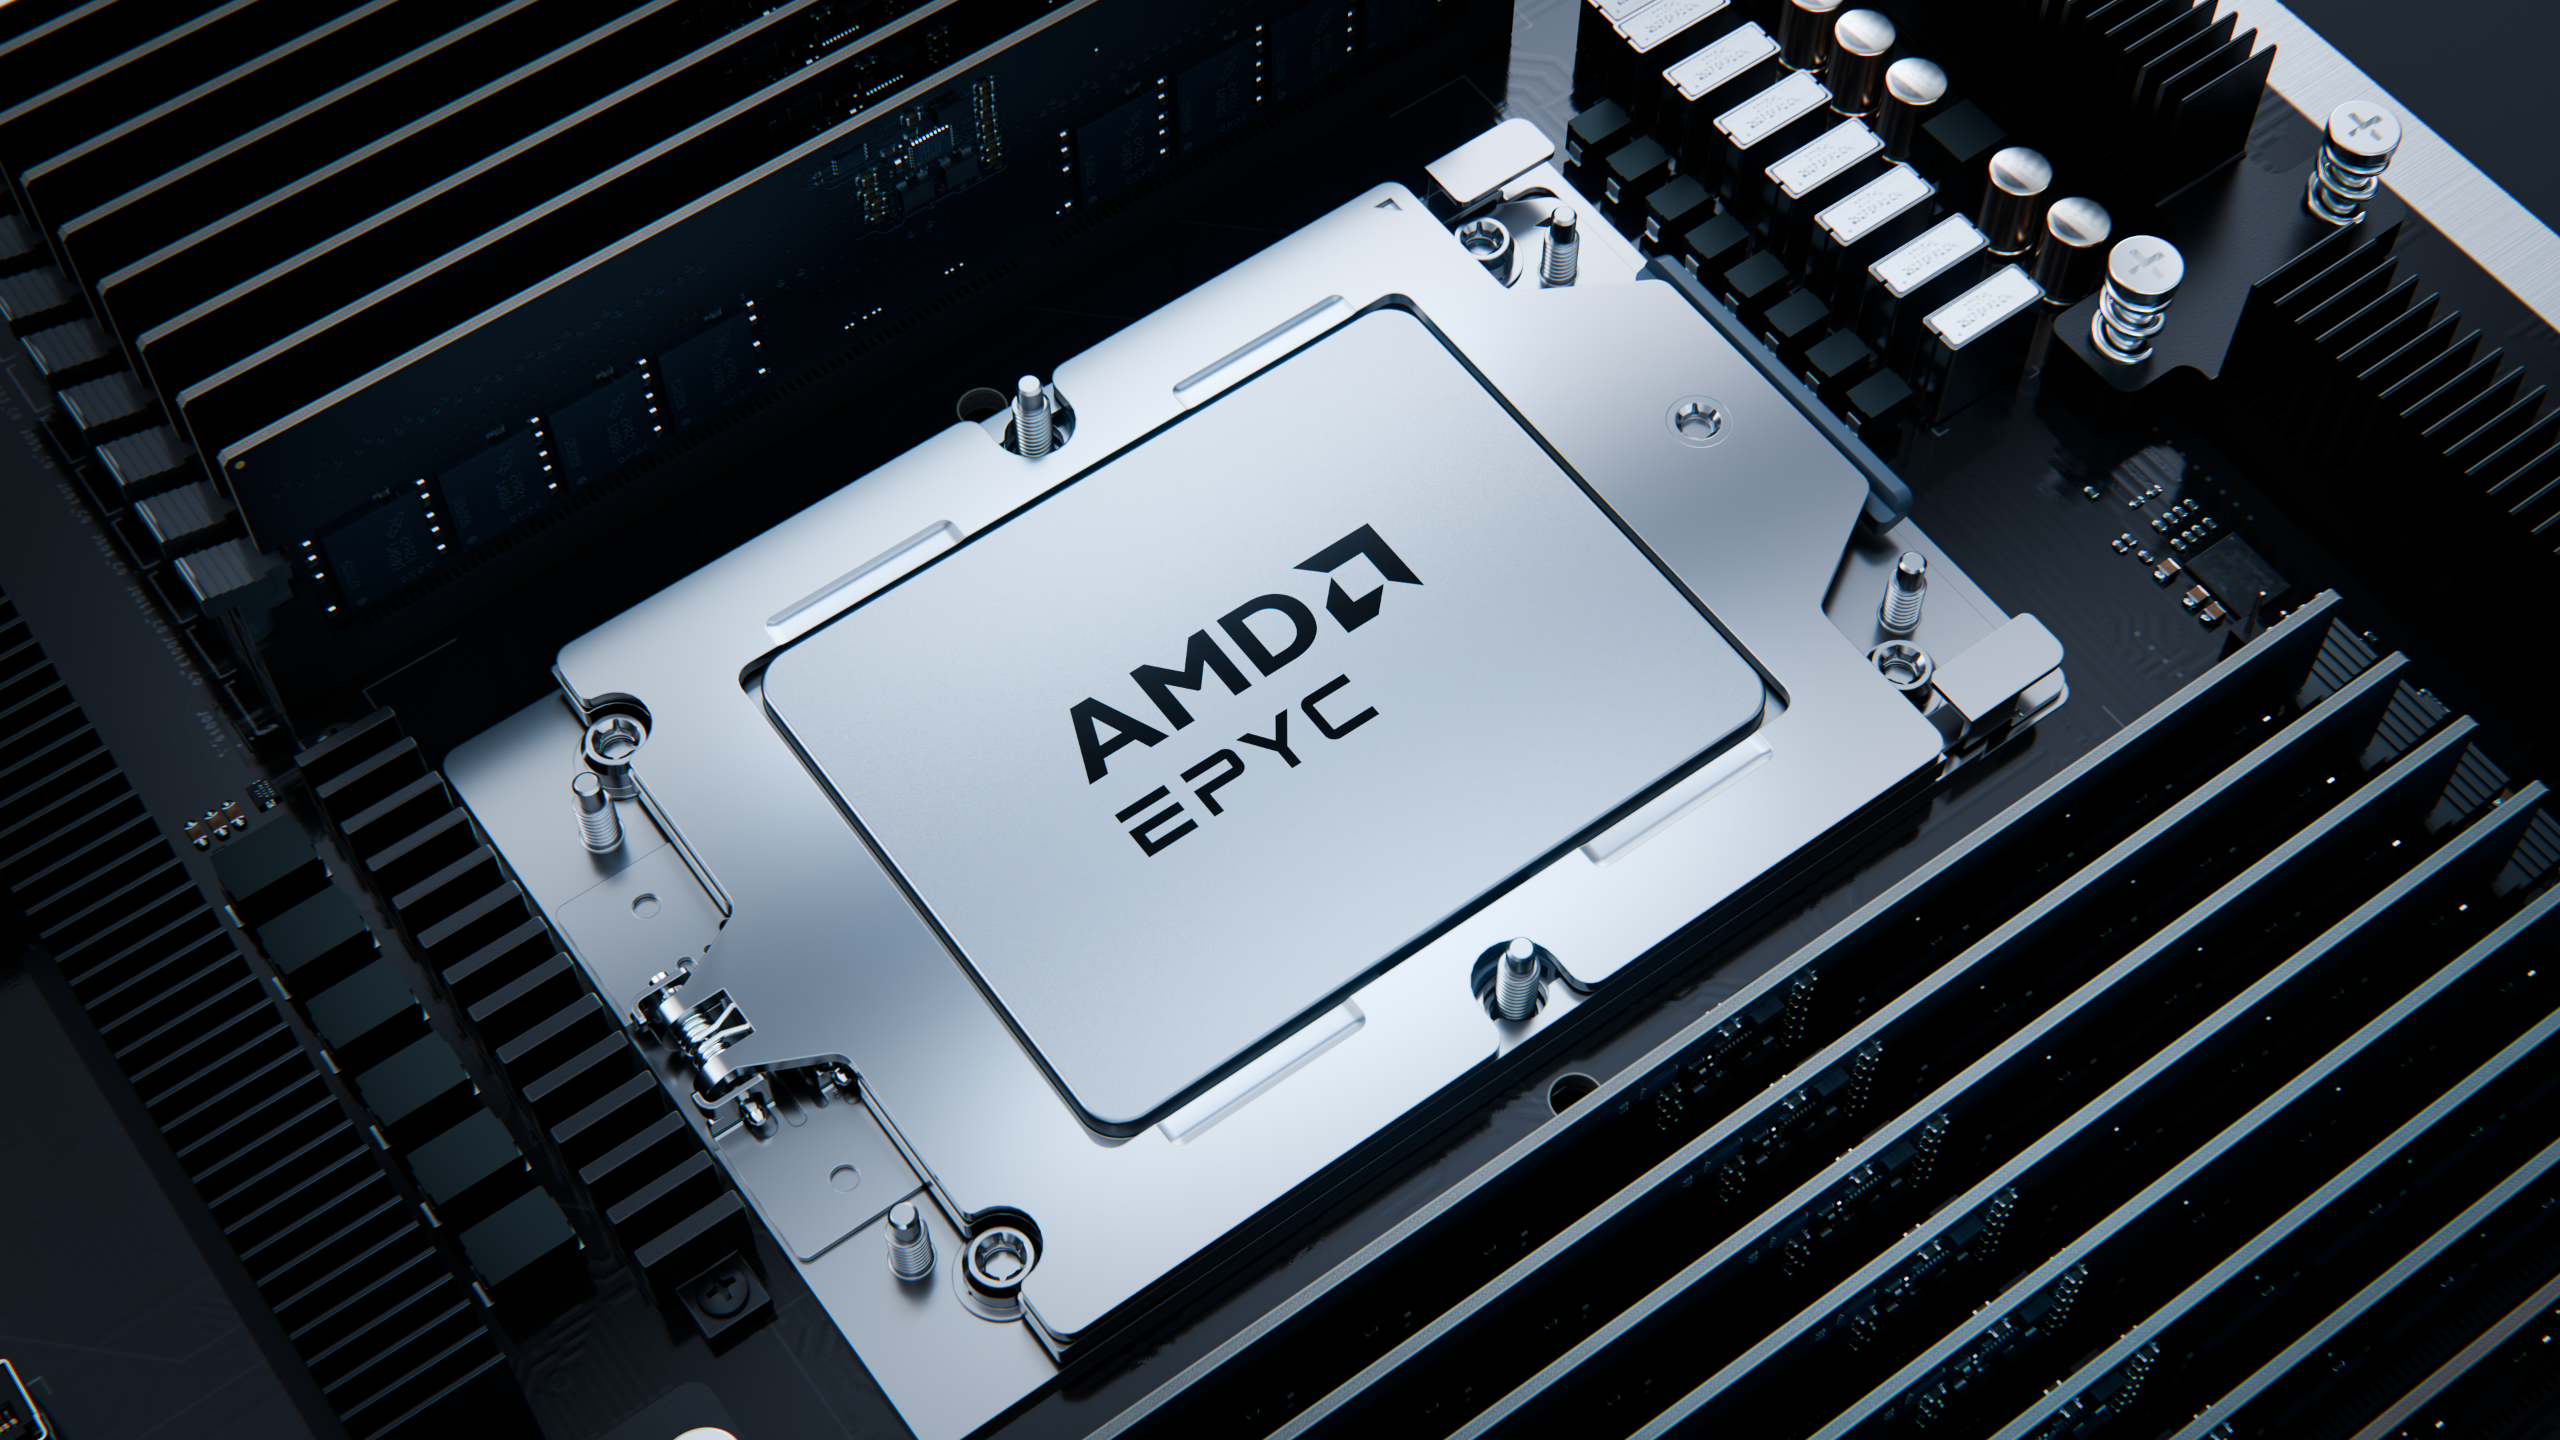
据 Tom's Hardware 报道,AMD 正在为人工智能服务器开发一款代号为“韦拉诺”(Verano)的全新 EPYC 处理器,该芯片将作为 AI 主控使用,并采用前所未有的 SB1 专用插槽。这款基于 Zen 6 架构的处理器,将搭配 24 通道 LPDDR5X 内存子系统,进一步巩固 AMD 在 AI 基础设施领域的技术布局。
头条新闻韦拉诺的定位:AI 服务器的专用“大脑”
根据曝光的工程信息,EPYC“韦拉诺”并非传统的通用服务器 CPU,而是专门针对 AI 集群中的“主控节点”(Host Node)设计。根据报道内容,该芯片将集成 72 个 Zen 6 架构的物理核心,远高于当前主流 64 核或 96 核的通用 EPYC Turin 系列。这款芯片的核心任务并非直接进行大规模并行计算,而是作为 AI 加速器集群的前端,负责任务调度、数据传输以及管理 GPU 或 AI 加速器的协同工作。
今日头条与传统 EPYC 处理器使用 SP5 或即将发布的 SP6 插槽不同,“韦拉诺”将采用一个名为“SB1”的全新插槽。业内分析人士指出,SB1 插槽的引入可能源于该芯片对高带宽内存的极端需求——24 通道 LPDDR5X 内存控制器的引入,使得处理器引脚定义和物理尺寸发生了根本性变化。
新闻头条24 通道 LPDDR5X:内存带宽的革命性提升
“韦拉诺”最引人注目的技术规格是其 24 通道 LPDDR5X 内存子系统。目前,无论是英特尔还是 AMD 的顶级服务器平台,普遍采用 12 通道 DDR5 配置。直接翻倍至 24 通道,且采用功耗和延迟更低的 LPDDR5X,意味着内存带宽将达到前所未有的水平。
新闻快讯据可靠消息来源,该设计允许芯片板载最高 768 GB 的 LPDDR5X 内存。相较于传统服务器 DIMM 插槽,这种焊装(soldered-down)方案能大幅缩短信号传输路径,从而降低延迟并提高能效。对于 AI 推理任务,特别是处理需要海量模型参数的大语言模型(LLM)时,巨大的内存带宽将显著减少模型加载和缓存交换的等待时间。
新闻资讯下表对比了“韦拉诺”与当前主流数据中心 CPU 在核心配置与内存规格上的差异:
| 处理器型号 | 核心数 | 内存通道数 | 内存类型 | 插槽类型 | 主要用途 |
|---|
| --- | --- | --- | --- | --- | --- |
|---|
| AMD EPYC 9965 (Turin) | 192 | 12 | DDR5-6000 | SP5 | 通用计算/高性能计算 |
|---|
| Intel Xeon 6980P (Granite Rapids) | 128 | 12 | DDR5-6400 | LGA 7529 | 通用计算/AI 训练 |
|---|
| AMD EPYC Verano (AI Host) | 72 | 24 | LPDDR5X | SB1 (专用) | AI 集群主控节点 |
|---|
Tom's Hardware 指出,这一配置暗示“韦拉诺”并非为了跑出更高的 CPU 算分,而是专注于数据吞吐与协调。
Zen 6 架构:专为 AI 工作负载优化
根据线路图泄露的信息,Zen 6 架构将在 Zen 5 基础上进行重大改进。虽然 AMD 官方尚未正式公布 Zen 6 的微架构细节,但行业观察人士普遍预期,新架构将引入针对矩阵运算(Matrix Engine)的增强指令集,以及更智能的缓存预取机制。
一位不愿具名的行业分析师向媒体透露:“AMD 的 Zen 6 爬虫(cRawler)核心设计表明,公司正在为每一瓦性能精打细算。72 个核心加上 24 通道 LPDDR5X,这意味着每个核心都能近乎独占地访问整个内存池,这在处理 AI 推理的随机访问模式时极具优势。”
结合近期曝光的 AMD Core Performance Boost(CPB)技术升级,“韦拉诺”据称能够根据 AI 任务的负载类型,动态调整部分核心的频率和电压,另一部分核心则可能完全关闭以节省功耗。
SB1 插槽:AM5 与 SP5 之外的第三个生态
SB1 插槽的引入,意味着 AMD 将为其 AI 主控产品线建立一个独立的物理生态。Tom's Hardware 从供应链消息人士处获悉,SB1 插槽的尺寸显著大于现有的 SP5 插槽,拥有超过 6000 个引脚。这并非为了容纳更多的 I/O 通道,而是为了给 24 通道 LPDDR5X 内存提供足够的信号完整性。
“SB1 是一个高密度、高成本的解决方案。它更接近于一个大型封装基板,而非传统 CPU 插槽,”消息人士称,“同时,这个接口很可能也为未来的直接芯片间互联(如 AMD Infinity Architecture 的下一代版本)预留了通道。”
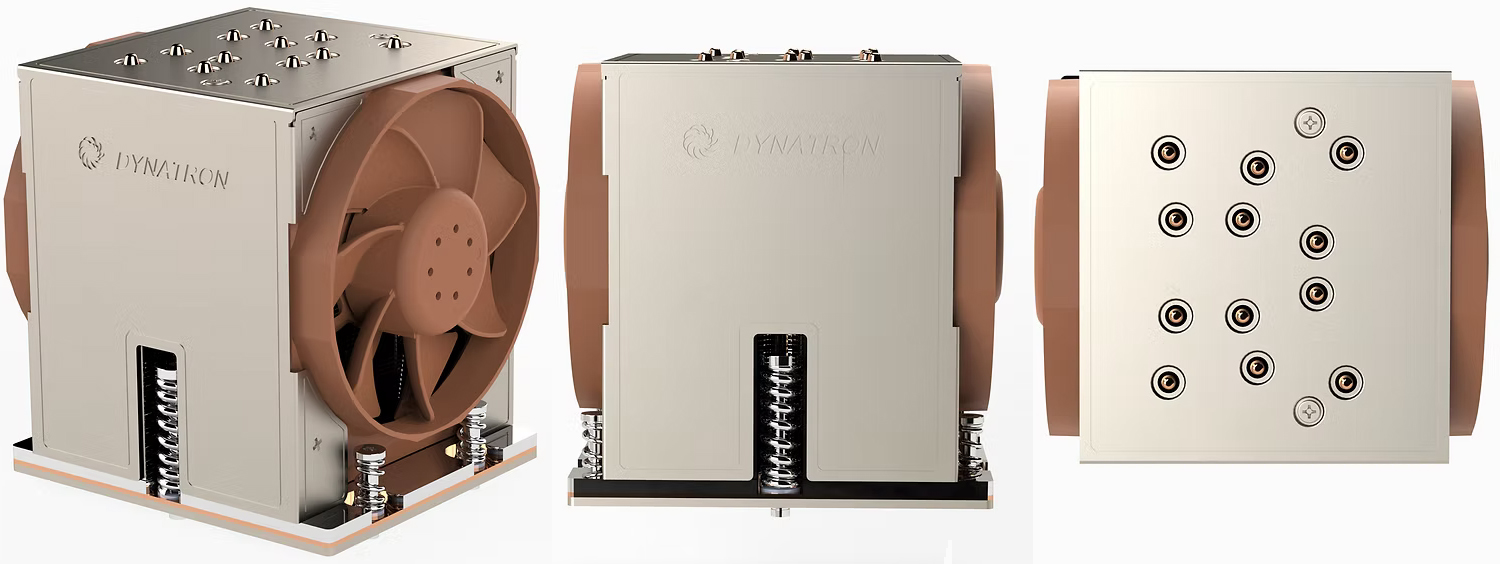
这意味着主板制造商需要为其设计全新的板型和散热方案。由于 LPDDR5X 内存焊装在 CPU 基板附近或基板上,主板设计将更加集成化,可能会大幅降低传统服务器主板上内存插槽所占用的面积。
对 AI 基础设施的深远影响
如果“韦拉诺”能够顺利落地,它可能改变 AI 服务器的建设模式。目前,业界普遍采用 GPU 直连 CPU 内存的逻辑设计。而当 CPU 自身拥有 24 通道高速内存时,AI 主控节点将有能力在本地缓存更多模型参数,减少与远端内存(如 CXL 内存池)的交互压力。
AMD 企业副总裁(官方声明中提及但未具名)在早先的一份内部通讯中指出:“未来的 AI 数据中心集群中,主控 CPU 的内存带宽将成为性能瓶颈。韦拉诺正是为解决这一瓶颈而生。”
这一设计思路与英伟达 Grace Hopper 超级芯片的做法异曲同工——为 CPU/GPU 复合体提供超大规模本地内存。但 AMD 通过 72 核和通用架构,可能在灵活性和任务兼容性上超过基于 ARM 架构的英伟达 Grace CPU。
与竞争对手的博弈:英特尔与 NVIDIA 的应对
面对 AMD 的 SB1 专用生态,英特尔也在加速其“至强 6”系列中针对 AI 优化的变体。不过,英特尔目前的规划仍然基于通用 LGA 7529 插槽,尚未有专门针对 AI 主控节点独立开模的公开计划。
Tom's Hardware 对比发现,虽然英特尔拥有嵌入式多芯片互连桥接(EMIB)技术用于异构集成,但 AMD 的“韦拉诺”与英伟达的 Grace CPU 直接对抗的意图更为明显。英伟达 Grace 基于 ARMv9 架构,拥有 72 个核心,并配备 64 个品牌的 LPDDR5X。Tom's Hardware 在文中援引知情人士说法称:“英伟达的 Grace 提供了 500 GB/s 的内存带宽,韦拉诺的 24 通道如果采用 LPDDR5X-8533,理论带宽将突破 600 GB/s,这将是一个非常致命的规格。”
API 生态系统与软件兼容性
任何强大的硬件都需要软件生态的支撑。虽然“韦拉诺”硬件规格惊人,但 AMD 必须在 ROCm 软件栈中提供对 SB1 插槽及板载 LPDDR5X 内存模型的高级支持。

一位资深的 HPC 系统架构师评论说:“硬件只是故事的一半。如果 ROCm 无法像 CUDA 那样有效管理本地非一致内存访问(NUMA),那么这些带宽优势都将被浪费。AMD 必须确保 PyTorch、TensorFlow 等主流框架能够‘开箱即用’地利用 24 通道内存。”
值得注意的是,AMD 近期在开源社区投入巨资优化 ROCm 6.0,该版本专门针对大语言模型推理进行了底层改进。如果“韦拉诺”与 ROCm 6.x 同步优化,AMD 将拥有一个非常完整的 AI 主控工具链。
预期时间线与市场展望
按照 AMD 近两年的发布节奏,Zen 6 架构预计在 2026 年下半年开始逐步部署。Tom's Hardware 推测,“韦拉诺”作为专有 ASIC 类别的 CPU,可能先于通用 Zen 6 EPYC(代号“Venice”)亮相,首发时间可能在 2026 年第四季度至 2027 年第一季度之间。
定价方面,鉴于其专用性和高成本内存配置,“韦拉诺”的单价很可能远超当前的旗舰 EPYC 9965。对于超大规模云服务商和大型 AI 企业来说,性能提升所带来的 TCO 优化可能远高于纯硬件成本。
常见问题解答(FAQ)
Q1: AMD EPYC “韦拉诺”的主要竞争对象是谁?
A1: 其主要竞争对象是英伟达的 Grace CPU 超级芯片。两者都旨在为 AI 训练和推理集群提供高带宽、低延迟的内存解决方案,作为 GPU 或 AI 加速器的主控处理器。不过,“韦拉诺”基于 x86 Zen 6 架构,在软件兼容性和通用计算能力上可能比 ARM 架构的 Grace CPU 更具优势。
Q2: 为什么“韦拉诺”不采用传统的 DDR5 DIMM 设计,而是使用 LPDDR5X?
A2: 采用 LPDDR5X 焊装方案主要是为了满足极端的内存带宽需求。24 通道的 LPDDR5X 在物理上可以更靠近计算核心,大幅缩短信号传输距离,从而降低延迟并提高能效。虽然牺牲了可扩展性(无法手动插拔升级内存),但在 AI 推理这种对延迟和带宽极度敏感的特定场景下,性能收益远大于可维护性的损失。
总而言之,AMD EPYC “韦拉诺”的问世,标志着 x86 架构在 AI 专用化道路上迈出了重要一步。通过引入 72 核心的 Zen 6 架构、24 通道 LPDDR5X 内存以及全新的 SB1 生态,AMD 正试图在竞争激烈的 AI 基础设施市场中定义一个新的性能标准。
Related Threads - 游戏版本
AMD 正在开发代号“韦拉诺”的 AI 主控 EPYC 处理器,采用全新 SB1 插槽、72 个 Zen 6 核心及 24 通道 LPDDR5X 内存。本文深入分析这一革命性设计如何与英伟达 Grace 竞争,并改变未来 AI 服务器架构。