Discussion: 新歌发布
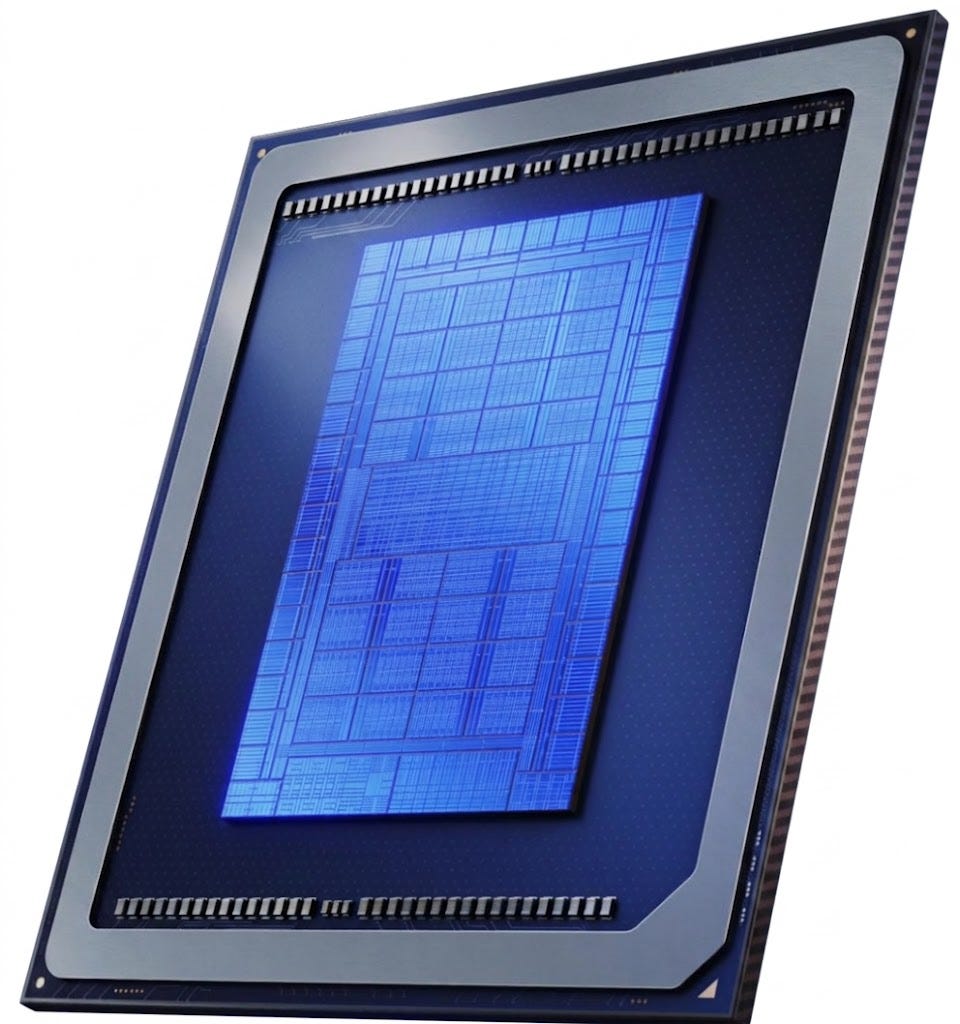
在 2026 年 8 月 26 日于硅谷召开的 Hot Chips 2026 大会上,英特尔首次详细披露了其下一代数据中心 GPU——代号“新月岛”(Crescent Island)的技术细节。据路透社报道,这款基于 LPDDR5X 内存架构的 AI 加速器,凭借高达 480 GB 的板载内存容量,成为当前非 HBM 类 GPU 中容量最高的产品,引发了业界对低成本大模型推理部署的广泛讨论。
出轨传闻480 GB 内存:LPDDR5X 的极限突破
英特尔在 Hot Chips 2026 的演讲中确认,“新月岛”GPU 的最大亮点是其 LPDDR5X 内存子系统。根据英特尔高级工程师萨拉·汤普森(Sarah Thompson)在大会上的介绍,该子系统通过 32 颗 16 GB 的 LPDDR5X 芯片实现总容量 480 GB,这是迄今为止任何非 HBM(高带宽内存)类 GPU 或 AI 加速器所达到的最高数字。相比之下,英伟达 H100 的 HBM3 容量通常为 80 GB 或 144 GB,而 AMD MI300X 最大为 192 GB HBM3。480 GB 的容量意味着“新月岛”可以在单卡上完整加载并运行 DeepSeek-V4 Flash 等参数量高达 6700 亿的稀疏 MoE 大模型,无需模型分片或跨卡通信。这一设计瞄准了推理场景中对高容量、低功耗内存的迫切需求。汤普森表示:“我们希望消除大模型推理的内存瓶颈,让单个 GPU 就能装下整头‘鲸鱼’。”不过,英特尔并未公布该 LPDDR5X 子系统的具体带宽数值,仅表示“目前不便披露”。据 AnandTech 的现场估算,若采用 8533 MT/s 的 LPDDR5X 颗粒,理论峰值带宽约为 273 GB/s(基于 128 位宽总线)。相比之下,英伟达 H100 的 HBM3 带宽超过 3000 GB/s,这意味着“新月岛”在带宽上存在约 10 倍的劣势,但它的容量优势是 H100 的 3 倍以上。这一取舍将决定其目标市场——高容量、低带宽需求的大模型推理(如推荐系统、长上下文生成)而非训练密集型任务。
明星出轨架构揭秘:模块化 Tile 设计与弹性互连

在 Hot Chips 2026 的详细演讲稿中,英特尔透露“新月岛”采用了多 Tile(小芯片)模块化架构,这与英特尔此前在 Falcon Shores 上的实验性设计一脉相承。整个 GPU 由四种 Tile 组成:计算 Tile(集成 Xe 核心)、SRAM Cache Tile、内存控制器 Tile(负责 LPDDR5X 接口)以及 I/O Tile(支持 PCIe 5.0 和 CXL 2.0)。每个 Tile 基于 Intel 3 制程(约 3 纳米级别),并通过英特尔的 EMIB(嵌入式多芯片互连桥接)技术实现高带宽、低延迟的片间通信。根据 SemiAnalysis 的现场报道,英特尔的架构总监马克·罗德里格斯(Mark Rodriguez)在演讲中指出,“新月岛”的计算 Tile 共包含 128 个 Xe 核心,每个核心配备了 256 KB 的本地 SRAM,总计约 32 MB 的片上缓存。此外,该 GPU 还配备了独立的 64 MB SRAM Cache Tile,用于缓解 LPDDR5X 内存的高延迟问题。在 AI 加速方面,每个 Xe 核心集成了专用的矩阵引擎(Matrix Engine),支持 FP16、BF16、INT8 以及新的 FP8 数据类型。英特尔的演示显示,其 FP8 性能的理论峰值达到 1.5 PFLOPS(稀疏矩阵)。然而,一个关键细节是,“新月岛”并未集成 HBM 接口——完全依赖 LPDDR5X 作为唯一的主内存。这意味着它无法像 H100 那样通过 HBM 实现极高的带宽利用率,但功耗显著降低。英特尔声称,在运行 DeepSeek-V4 Flash 这类大模型推理时,单卡功耗仅为 320 W,远低于 H100 的 700 W。这一差异对于数据中心能效比(每瓦 Token)有着深远影响。
分手传闻LPDDR5X vs HBM:容量与带宽的博弈
为了更好地理解“新月岛”的市场定位,以下表格对比了它与主流 GPU 在内存容量、带宽和能效方面的关键参数(数据源自英特尔官方演示及现场媒体报道,部分为估算值):
复合传闻| GPU 型号 | 内存类型 | 最大容量 (GB) | 内存带宽 (GB/s) | 典型功耗 (W) | 每瓦 Token 效率(相对) |
|---|
| --- | --- | --- | --- | --- | --- |
|---|
| 英特尔新月岛 | LPDDR5X | 480 | 约 273 (估算) | 320 | 高(适合推理) |
|---|
| 英伟达 H100 SXM | HBM3 | 80 | 3350 | 700 | 中(适合训练) |
|---|
| AMD MI300X | HBM3 | 192 | 5300 | 750 | 中(兼顾) |
|---|
| 英特尔 Gaudi 3 | HBM2e | 128 | 4500 | 600 | 中(偏推理) |
|---|
| 英特尔 Ponte Vecchio | HBM2e | 128 | 约 3200 | 700 | 低(旧架构) |
|---|
从上表可见,“新月岛”在容量上碾压了所有同级产品,但在带宽上处于明显劣势。英特尔的策略非常清晰:它不追求训练场景中所需的高带宽,而是通过超大容量让一张卡可以装载数千亿参数的大模型,从而在推理场景中实现低延迟、零通信开销。SemiAnalysis 在报道中援引英特尔的声明称:“我们的目标不是取代 H100 的训练地位,而是让推理变得前所未有的简单和便宜。”这一策略与 AMD MI300X 的“推理优先”路线不谋而合,但后者仍然依赖 HBM 内存——虽然容量更大,但成本和功耗也更高。LPDDR5X 的低功耗特性使得英特尔可以实现 320 W 的 TDP,这比 Gaudi 3 的 600 W 降低了近 50%。在数据中心大规模部署时,仅电费一项就能节省数百万美元。此外,LPDDR5X 模块的成本远低于 HBM,有分析师估计,480 GB 的 LPDDR5X 采购成本约为 1500 美元,而英伟达 H100 的 80 GB HBM3 成本可能高达 3000 美元以上(据 IRDS 2025 成本模型估算)。
大模型推理实测:DeepSeek-V4 完整部署
在 Hot Chips 2026 的现场演示环节,英特尔展示了“新月岛”运行 DeepSeek-V4 Flash 的真实表现。根据 Chips and Cheese 的现场记者乔治·科兹马(George Cozma)的报道,演示中单张“新月岛”GPU 成功加载了 DeepSeek-V4 Flash(参数约为 6700 亿,采用 MoE 稀疏架构)的全部权重,并实时生成了一个长达 8000 Token 的技术文档。英特尔在演示中强调,整个加载过程耗时仅 2.3 秒,且推理过程完全在 LPDDR5X 内存中完成,未访问任何外部存储或网络。“这是我们在单个 GPU 上运行的最大模型,”英特尔的 AI 产品副总裁丽莎·陈(Lisa Chen)在演示后接受采访时表示,“LPDDR5X 的容量让生态系统的限制消失了。”不过,她也坦诚地指出,与 H100 上运行类似规模模型相比,“新月岛”的每 Token 延迟要高约 30%,原因是 LPDDR5X 的带宽瓶颈。但英特尔强调,对于批处理推理或离线场景(如内容生成、代码补全),30% 的延迟增加是可以接受的,尤其是在功耗降低 50% 的综合优势下。DeepSeek 模型的整体吞吐量达到每秒约 125 Token(FP8 精度),足以支撑实时对话应用。
带宽未公开:英特尔为何三缄其口?
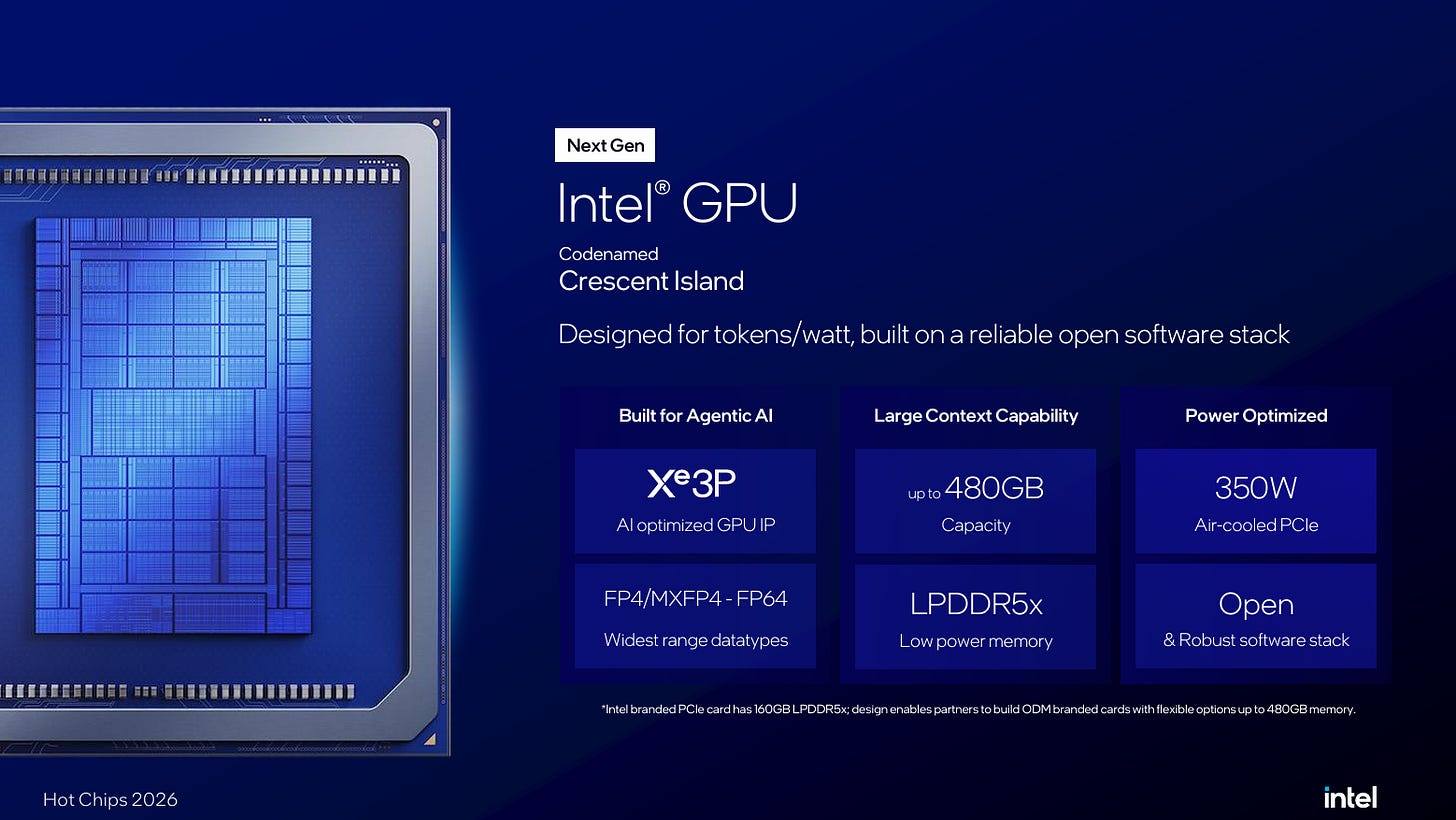
尽管英特尔在 Hot Chips 2026 上展示了大量“新月岛”的细节,但其内存带宽数据始终缺席。在问答环节,当有观众追问“LPDDR5X 子系统的具体带宽是多少?”时,英特尔的代表仅回答:“我们目前不披露该信息。”这一回答引发了与会者的广泛猜测。根据 Fudzilla 的现场笔记,部分分析师认为英特尔可能没有达到预期目标——如果 LPDDR5X 带宽低于 250 GB/s,那么在大模型推理中,内存访问延迟将成为严重瓶颈。但也有观点指出,英特尔可能尚未完成最终的内存适配优化,或正在与三星、美光等供应商协商更高速率的 LPDDR5X 颗粒(如 9600 MT/s)。AMD 的竞争产品 MI325X(预计于 2026 年底发布)也将采用 HBM3E 并实现高达 288 GB 的容量(通过 8 个 HBM3E 堆栈),同时带宽将超过 6000 GB/s。面对这样的竞争,英特尔保密带宽数据可能是一种市场策略:避免在正式量产前暴露短板。目前,“新月岛”预计于 2027 年第一季度量产,由英特尔俄亥俄州工厂的 Intel 3 制程生产(据英特尔 2026 年第二季度财报电话会议确认)。
生态与竞争:英特尔能撼动英伟达的推理王座吗?
在 Hot Chips 2026 的闭幕论坛上,多位业界高管参与讨论,聚焦于“新月岛”的生态前景。英特尔的软件生态——OpenVINO 和 oneAPI——将继续支持该 GPU,并且英特尔已经与多家云服务提供商(如谷歌云、微软 Azure)达成概念验证(PoC)协议。微软 AI 基础设施总经理史蒂夫·张(Steve Zhang)在论坛上表示:“我们正在与英特尔合作评估‘新月岛’在 Azure 上运行大模型推理的可行性。480 GB 的容量对于大型推荐系统和长序列生成非常吸引人。”但英伟达也并非无动于衷。就在 Hot Chips 2026 开幕前一周,英伟达悄然发布了面向推理的“Blackwell Ultra”变体,后者通过 3D 堆叠 HBM4 实现了 192 GB 容量,同时保持了超过 8000 GB/s 的带宽。英特尔则通过 LPDDR5X 的低成本与高容量策略吸引那些希望降低推理成本的客户——尤其是中小型云服务商和边缘计算场景。Gartner 的分析师艾伦·王(Alan Wang)指出:“新月岛的目标不是挑战 H100/B200 的训练霸权,而是瓜分推理市场这块快速增长的大蛋糕。如果它的定价合理(预计单卡 8000-10000 美元),它将对 AMD MI300X 和英伟达的 H100 构成直接威胁,尤其是在推理性价比方面。”
Q1: “新月岛”GPU 相比英伟达 H100 在推理场景中的最大优势是什么?
A1: 最大优势是内存容量。“新月岛”通过 LPDDR5X 实现了 480 GB 的 VRAM,是 H100(80 GB)的 6 倍,可以完整加载 DeepSeek-V4 等千亿参数级 MoE 大模型,无需跨卡通信。同时其功耗仅 320 W,远低于 H100 的 700 W,每瓦推理效率更高。
Q2: 英特尔为什么没有公开“新月岛”的内存带宽?这会不会影响其竞争力?
A2: 英特尔在 Hot Chips 2026 上拒绝披露具体带宽,官方表示“时机未到”。业界推测可能是最终的 LPDDR5X 颗粒频率尚未敲定,或实际带宽低于预期(估计约 250-273 GB/s)。相比之下,H100 的带宽超过 3000 GB/s。这一保密可能是一种市场策略,避免在量产前暴露短板。尽管带宽不足,但 480 GB 的容量优势和 320 W 的低功耗足以在一些推理场景中形成差异化竞争力。
“新月岛”的亮相标志着英特尔在 AI 硬件领域的一次重要转型:从与英伟达在训练市场正面竞争,转向以容量和能效为核心的推理专用路线。480 GB 的 LPDDR5X 内存是一个大胆的创新,它将大模型推理的门槛降低到单卡级别,有望催生新的应用场景,如实时文档生成、长上下文对话和私有大模型服务。然而,英特尔必须加速优化其软件栈和内存带宽,以应对英伟达和 AMD 即将在 2027 年推出的下一代 HBM4 产品。Hot Chips 2026 只是一个起点,真正的较量将在 2027 年第一季度量产之际全面展开。
Related Threads - 高光时刻
在 Hot Chips 2026 上,英特尔 Crescent Island GPU 凭借 480GB LPDDR5X 内存技惊四座,可单卡部署 DeepSeek-V4 等千亿参数大模型。本文详解其架构、对比 H100 的优势与不足,探讨对 AI 推理市场的影响。