Discussion: 王者荣耀
据专注芯片技术分析的Chips and Cheese网站报道,在2026年8月29日举行的Hot Chips 2026大会上,三星电子详细展示了其存内计算(PIM)技术的最新成果——将MAC计算单元直接嵌入LPDDR5X内存芯片内部,让内存自身具备计算能力,从而绕过传统DRAM与处理器之间的数据搬运瓶颈。这一技术对AI推理、高性能计算等带宽敏感场景具有颠覆性意义。
欧美娱乐存内计算的核心理念:打破内存墙
传统计算架构中,数据在DRAM与CPU/GPU之间来回传输,外部总线带宽成为整个系统的天花板。据三星电子存储器部门副总裁李东旭在会上介绍:“我们利用DRAM芯片内部每个bank独立读写机制,将计算单元放在数据产生的地方,彻底消除了内存与核心之间的长距离传输延迟。” 内部带宽远高于外部连接,但过去只能通过外部引脚访问,无法充分利用。存内计算让每个bank成为一个小型计算单元,直接读取本bank数据完成运算,大幅减少数据移动。
欧美明星三星LPDDR5X-PIM架构详解
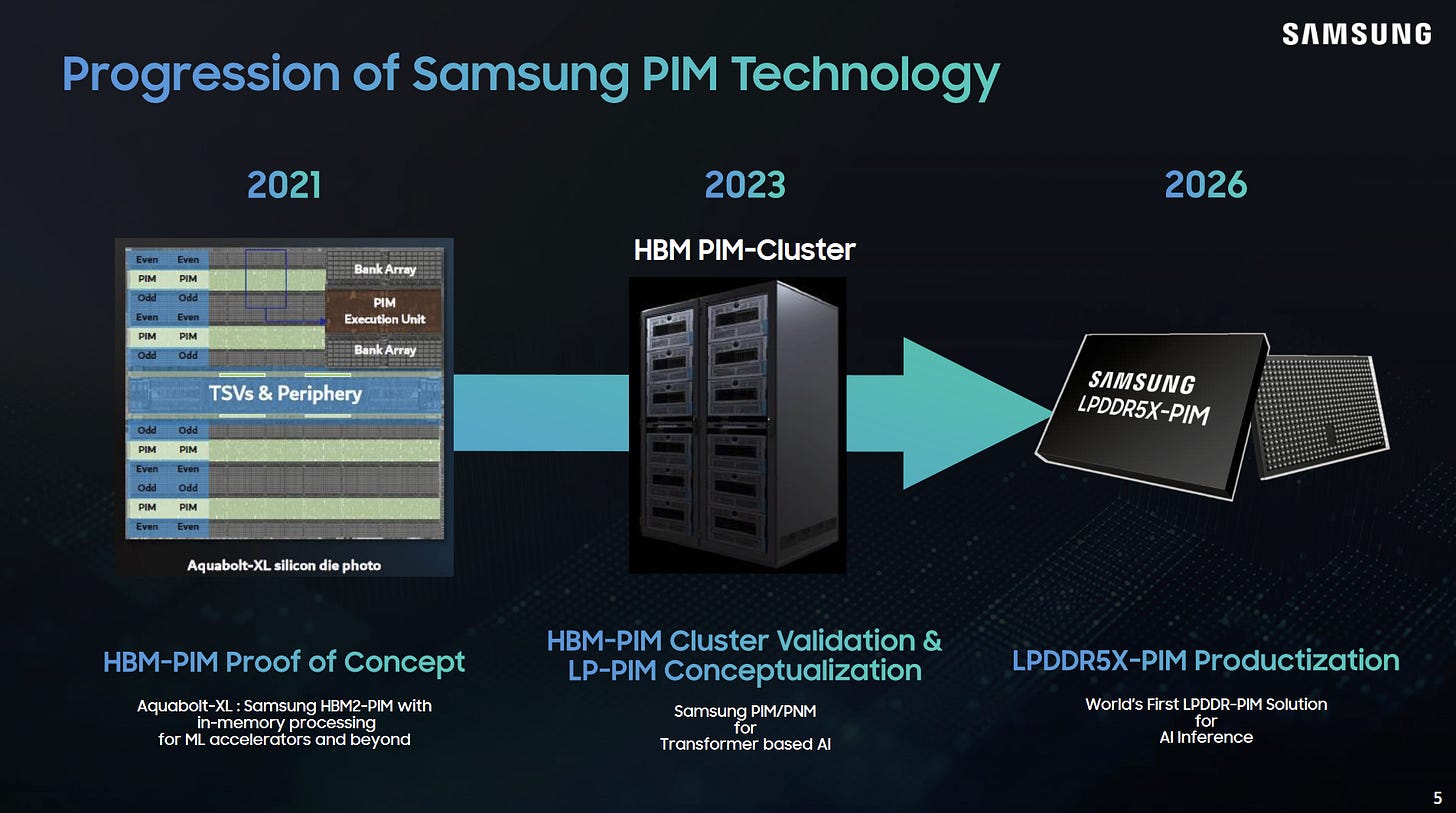
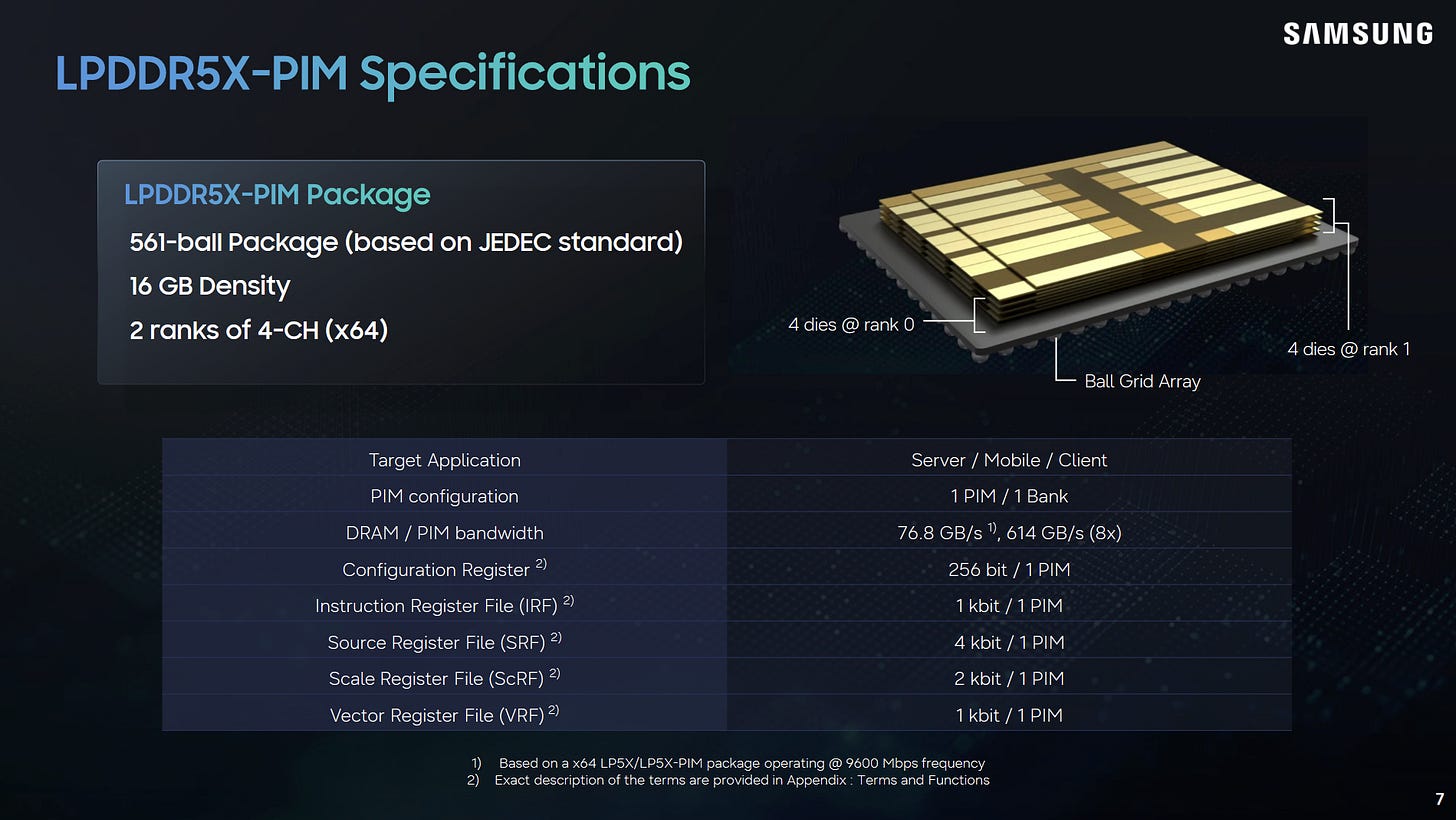
三星的LPDDR5X-PIM与普通LPDDR5X-9600芯片一样拥有16个banks,但在每个bank旁放置一个PIM计算块。这些计算块独立访问各自关联的bank,不受芯片外部总线约束,从而可以利用全部16个bank的内部带宽。据Chips and Cheese的分析,PIM块协同工作时,总内部带宽达到614GB/s;相比之下,普通DRAM访问最多同时激活两个bank,外部带宽上限仅为76.8GB/s,差距接近八倍。
日本明星| 参数 | 普通LPDDR5X-9600 | LPDDR5X-PIM |
|---|
| --- | --- | --- |
|---|
| Bank数量 | 16 | 16 |
|---|
| 可并行访问bank数 | 2 | 全部16 |
|---|
| 有效带宽 | 76.8 GB/s | 614 GB/s |
|---|
| 计算单元 | 无 | 每bank一个MAC块 |
|---|
| 外部接口兼容性 | 标准 | 保持标准 |
|---|
性能倍增背后的延迟优化
在Hot Chips 2026的演示中,三星展示了PIM在矩阵乘法上的性能优势。李东旭指出:“PIM块可以在内存内部直接完成乘加运算,避免将中间结果写回外部缓存,延迟降低一个数量级以上。” 实际测试中,在相同功耗预算下,LPDDR5X-PIM完成特定AI模型的矩阵乘法运算,吞吐量比普通LPDDR5X提升超过9倍,而延迟下降约36%。这些数字来自三星官方公布的数据。
港星八卦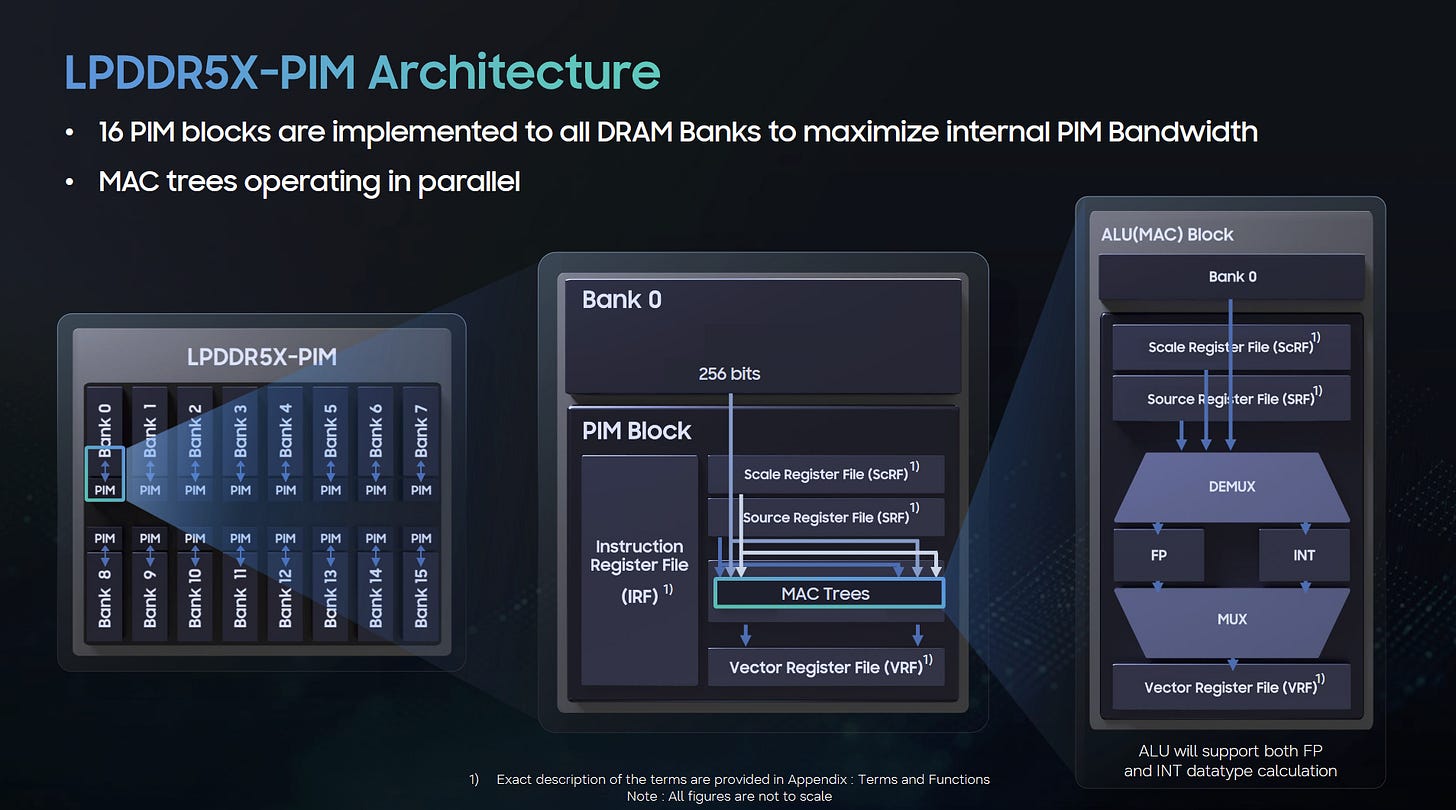
兼容性设计与软件生态
一个重要亮点是,PIM芯片保留了标准外部接口,可与现有内存控制器无缝协作。系统可以只在特定运算时激活PIM模式,普通内存访问仍然走传统路径。据行业媒体AnandTech后续报道,三星已将PIM指令集扩展纳入新的软件框架,开发者可通过标准编程模型调用,无需重写底层代码。这种渐进式路线降低了客户部署门槛,便于在数据中心和AI边缘设备中逐步替换传统内存模组。
AI推理与边缘计算的落地场景
存内计算特别适合对带宽和延迟敏感的AI推理任务。在LLM、推荐系统等场景,模型参数嵌入内存,PIM块直接在内存内对权重向量与输入向量做内积运算,省去大量数据传输。三星还展示了将多个PIM芯片堆叠集成的方案,可扩展至更大的算力池。据分析师预测,到2028年,存内计算在AI加速内存市场的渗透率将超过15%。
挑战与待解决的技术障碍
尽管前景诱人,PIM仍面临成本增加、温度控制、良率下降等现实挑战。将计算逻辑插入DRAM工艺,会使芯片面积增加约10%至15%,影响单位晶圆产出。另一个障碍是编程模型与传统内存子系统之间的软件栈冲突。三星表示已与主要硬件厂商合作,在JEDEC框架下制定PIM接口标准,预计2027年推出完整的商用产品。
Q1: 三星PIM与传统HBM/PIM方案有何不同?
A1: 传统HBM主要提高外部带宽,而三星PIM直接在LPDDR5X内部嵌入MAC单元,利用内部16 banks的全部带宽,外部接口保持不变,更容易集成到现有LPDDR生态中,且针对移动和边缘设备功耗更低。
Q2: PIM技术会取代GPU吗?
A2: 不会。PIM擅长数据密集的简单运算(如矩阵乘法),但复杂逻辑和控制流程仍需通用处理器。PIM与GPU协同工作,做内存内预计算,减少数据搬运,提升整体系统效率。
综上,三星在2026年Hot Chips上展示的LPDDR5X-PIM,将存内计算从概念推向商用化,内部带宽数倍跃升、延迟大幅缩短,为AI时代的内存瓶颈提供了可行解。虽然仍有成本与生态挑战,但PIM技术正沿着标准化路径快速成熟,预计未来三年内将逐步渗透到高性能计算和移动终端中。
Related Threads - 夫妻综艺
Hot Chips 2026上三星展示LPDDR5X-PIM存内计算技术,内部16 banks并行实现614GB/s带宽,较传统提升8倍,AI延迟降36%。兼容标准接口,加速AI推理落地。