Discussion: 游戏段位
机器学习工作负载对 DRAM 容量的需求似乎永无止境。据 Chips and Cheese 报道,在 2026 年 8 月 23 日举行的 Hot Chips 2026 教程日上,一项名为 HBF(High Bandwidth Flash,高带宽闪存)的新兴技术引发了广泛关注。其核心理念是:闪存每 GB 容量的成本远低于 DRAM,那么能否用它来缓解 AI 加速器面临的内存墙困境?HBF 采用与 HBM 类似的封装形式,但底层实现却截然不同,它并非即插即用的内存替代品,而更像是一块集成到处理器封装内的 SSD。本文将从其技术原理、软件适配、性能模拟以及对未来 AI 计算架构的潜在影响等维度进行深度解析。
同回酒店HBF 技术解析:披着 HBM 外衣的闪存“异类”
HBF 虽然在物理形态上模仿了 HBM(高带宽内存),即通过 2.5D/3D 封装将存储立方体(cube)堆叠在计算芯片旁,但其内部架构和访问逻辑与 HBM 有着本质区别。据 Anurag Agarwal 和 Radhakrishna Giduthuri 在 Hot Chips 2026 上的演讲介绍,HBF 并非像英特尔 Optane 持久内存那样可以作为内存池的扩展。相反,它更像一个集成在处理器上的 SSD,软件需要通过 DMA(直接内存访问)在 HBF 和 DRAM 之间搬运数据。这意味着 HBF 的访问必须像访问块存储设备一样,以大型、对齐的块(chunk)为单位进行,而非系统内存所支持的细粒度随机访问。
牵手逛街软件栈的挑战:从即插即用到深度定制
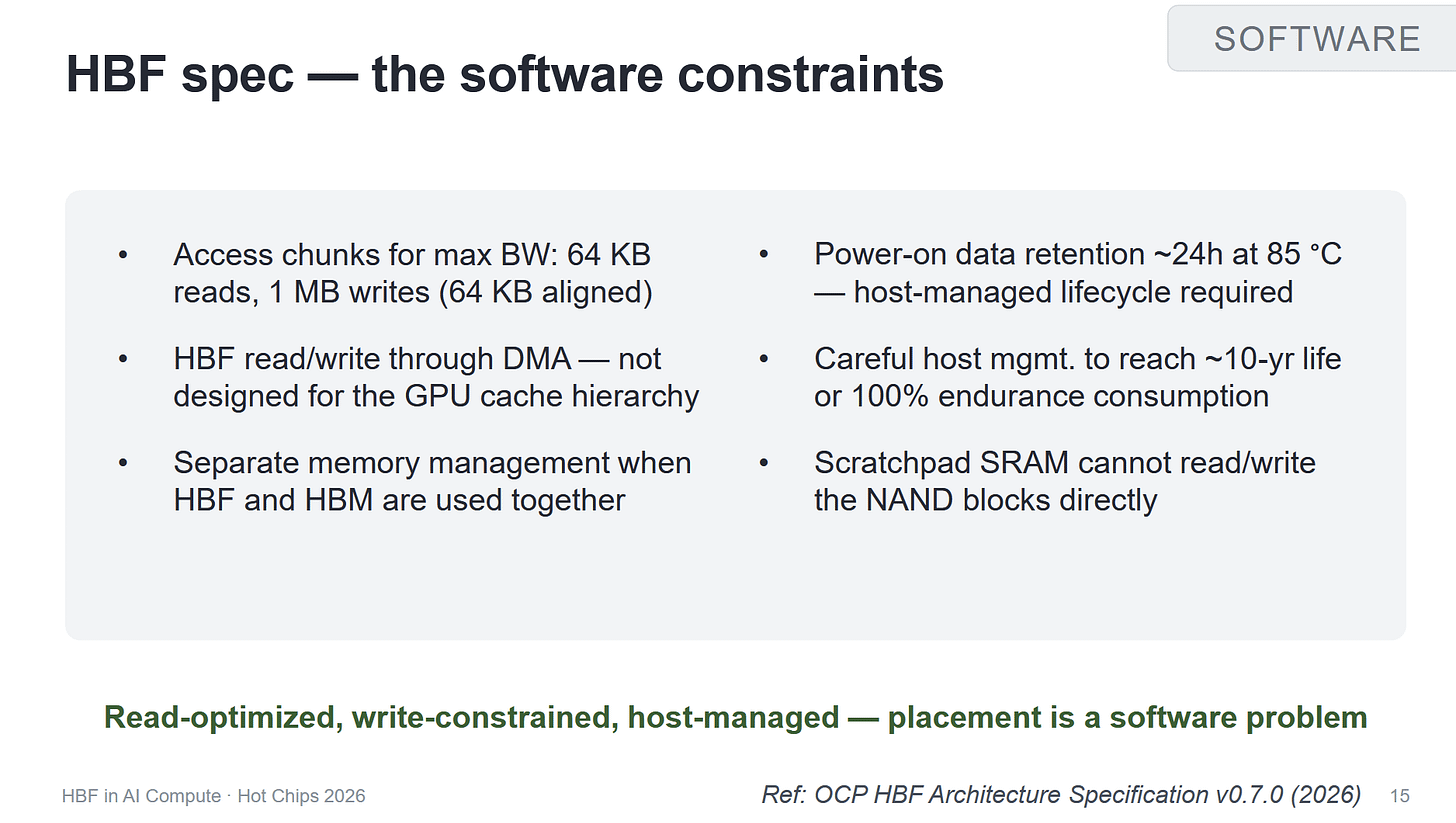
HBF 的引入对软件栈提出了前所未有的挑战。Giduthuri 指出,主机软件将不得不承担起原本属于 SSD 控制器的职责,例如管理写入均衡(write leveling)和确保数据持久性。这使得 HBF 无法成为一个“即插即用”的解决方案。据该演讲透露,诸如 vLLM 这类推理框架,通常将模型权重保存在 GPU 显存中,并已开始探索降低 VRAM(显存)使用的方案。例如,vLLM 正在研究将模型权重放置在主机端锁页内存中,但这对于不支持细粒度随机访问的 HBF 来说并不适用。
酒店幽会软件适配策略:以 vLLM 为例的 HBF 应用探索
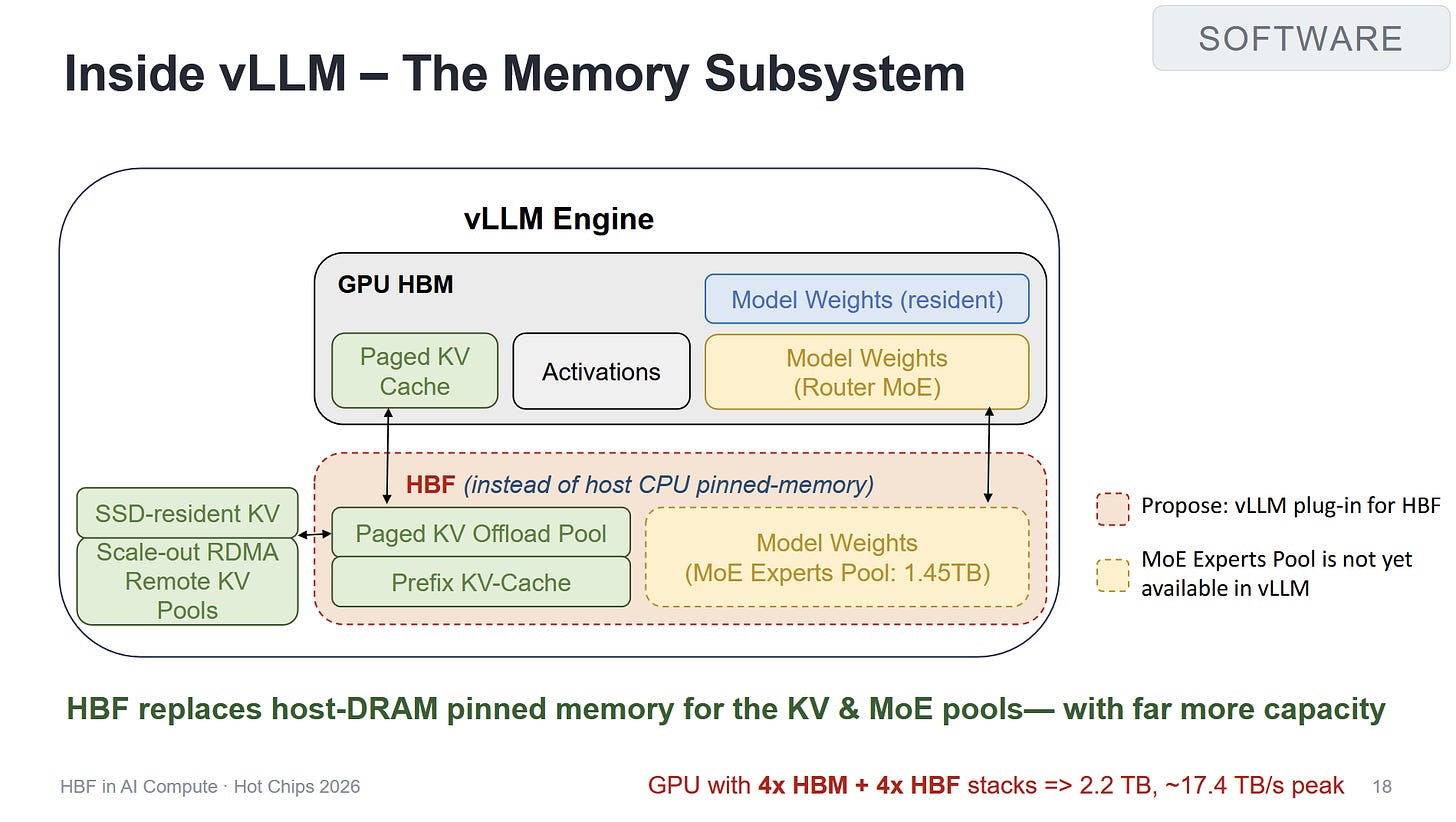
尽管面临挑战,演讲者认为 HBF 在特定场景下潜力巨大。一个极具前景的应用是存储 MoE(混合专家)模型的专家层。这些专家层参数庞大但使用频率相对较低,非常适合存放在 HBF 中。Giduthuri 表示,软件可以按需通过 DMA 将当前活跃的专家层数据加载到 HBM 中,从而在保持推理性能的同时,大幅降低对昂贵 HBM 容量的依赖。这种“数据分层”的策略,有望将 AI 推理的硬件成本降低一个量级。
明星结婚性能模拟与前景展望:HBF 与 HBM 的权衡
由于目前尚无 HBF 产品问世,该演讲主要基于模拟和性能预测。根据演讲中展示的数据,HBF 的单立方体容量可达 128GB 或更高,远超当前 HBM3E 的 24GB 单堆栈容量,但其带宽(预计在 1-2 TB/s 级别)和访问延迟(约 1-2 微秒,远高于 HBM 的纳秒级)与 HBM 相比仍有显著差距。下表对比了两者的关键特性:
| 特性 | HBF (预测) | HBM3E (当前) |
|---|
| --- | --- | --- |
|---|
| 单封装最大容量 | 1TB - 4TB | 128GB - 192GB |
|---|
| 访问带宽 | 1 - 2 TB/s | 4.8 - 8 TB/s |
|---|
| 访问延迟 | ~1 - 2 微秒 | ~100 - 200 纳秒 |
|---|
| 访问粒度 | 4KB - 64KB 块 | 32 - 64 字节 |
|---|
| 每 GB 成本 | 远低于 DRAM | 高 |
|---|
系统架构演进:HBF 与 HBM 的协同工作
Agarwal 和 Giduthuri 在演讲中强调,HBF 的目标并非取代 HBM,而是作为其补充,共同构建一个更优化的内存层级。在未来的 AI 加速器设计中,HBM 将继续扮演高速缓存的角色,存放热数据和当前计算所需的权重,而 HBF 则作为大容量、低成本的“近存存储层”,容纳整个模型权重或大规模知识库。这种设计可以显著提升单节点能够承载的模型规模,减少多节点间的通信开销。
未来挑战:寿命与生态系统的双重考验
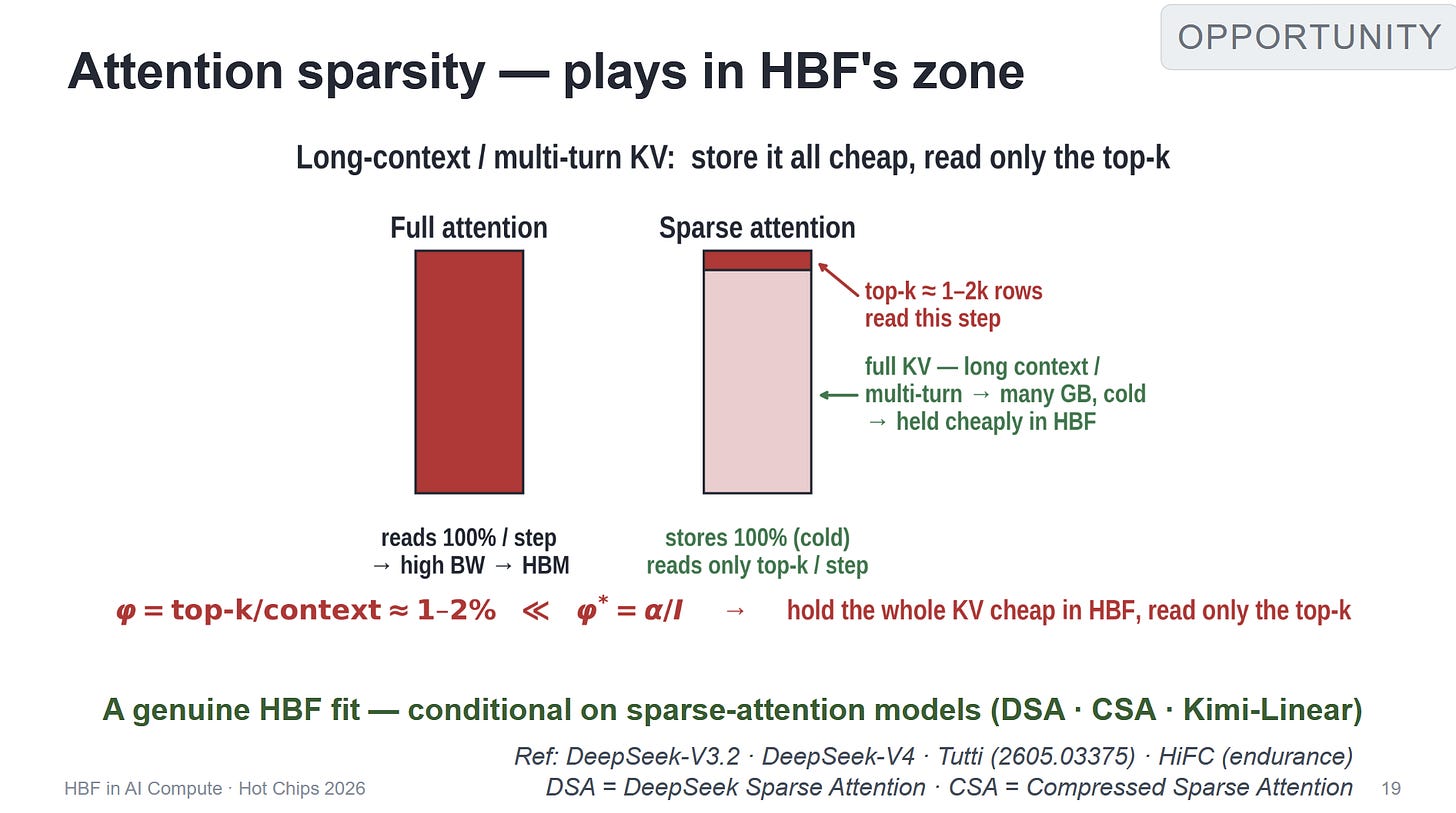
尽管前景诱人,HBF 的大规模商用仍面临诸多挑战。首先,闪存的写入寿命有限(通常为 3K-10K P/E 周期),在高强度训练负载下是否能够满足可靠性需求仍是未知数。其次,HBF 需要全新的软件框架、驱动程序和编程模型支持。AP 通讯社的报道也印证了这一观点,指出内存制造商正在评估将 3D NAND 闪存堆叠到逻辑芯片上的技术可行性,但统一的标准和软件接口尚未形成。
FAQ 常见问题解答
Q1: HBF 和普通 SSD 有什么区别?
A1: 虽然都基于闪存技术,但 HBF 通过 HBM 类似的 2.5D/3D 封装直接与计算芯片集成,物理距离极近,因此其访问带宽可达 TB/s 级别,远超通过 PCIe 接口连接的普通 SSD(通常为 10-20 GB/s)。但 HBF 仍然以块为单位访问,需要 DMA 搬运数据。
Q2: HBF 真的能解决 AI 的内存瓶颈吗?
A2: 部分可以。它通过大幅增加单节点的内存“容量”来解决“内存墙”问题,使得更大的模型可以运行在更少的 GPU 上。但它并未解决“带宽墙”问题,对于需要极高带宽的细粒度访问场景,HBF 并不适用。因此,它是一种“容量革命”,而非“带宽革命”。
面对机器学习对内存容量永不满足的渴求,HBF 提供了一条极具吸引力的技术路线。尽管困难重重,但其“以容量换速度”的思路,为成本敏感的 AI 推理市场打开了一扇新的大门。HBF 的未来,将取决于半导体工艺、闪存寿命和软件生态的协同演进。
Related Threads - 时政新闻
Hot Chips 2026 大会聚焦 HBF(高带宽闪存)技术。本文深度解析 HBF 如何通过近存计算与 HBM 协同,以更低成本解决机器学习面临的内存墙瓶颈,并探讨其软件适配挑战。